文章认为,agent 在互动间隙回顾日志、修正笔记、重组记忆,能让 Claude 在跨会话任务中更有效地利用记忆。
文章把「agent 记忆」定义为:Claude 从与用户的互动和被指派的任务中获得、并在会话之间保留、稍后可作为上下文读取的知识。它不包括修改模型权重、单次对话内的学习,以及 compaction(用摘要替换旧轮次)。
文章称,Letta 与加州大学伯克利分校的研究者提出了 sleep-time compute,让模型利用互动间隙的空闲时间重组已有上下文。agent 可借此回顾日志、修正错误或产出新笔记,这一过程常被称为 dreaming。
在 Continual Learning Bench(CL-Bench)1.0 的数据库查询任务中,Claude 每道题都从新会话开始,但可以检索一个跨会话保留的记忆目录中的文件。
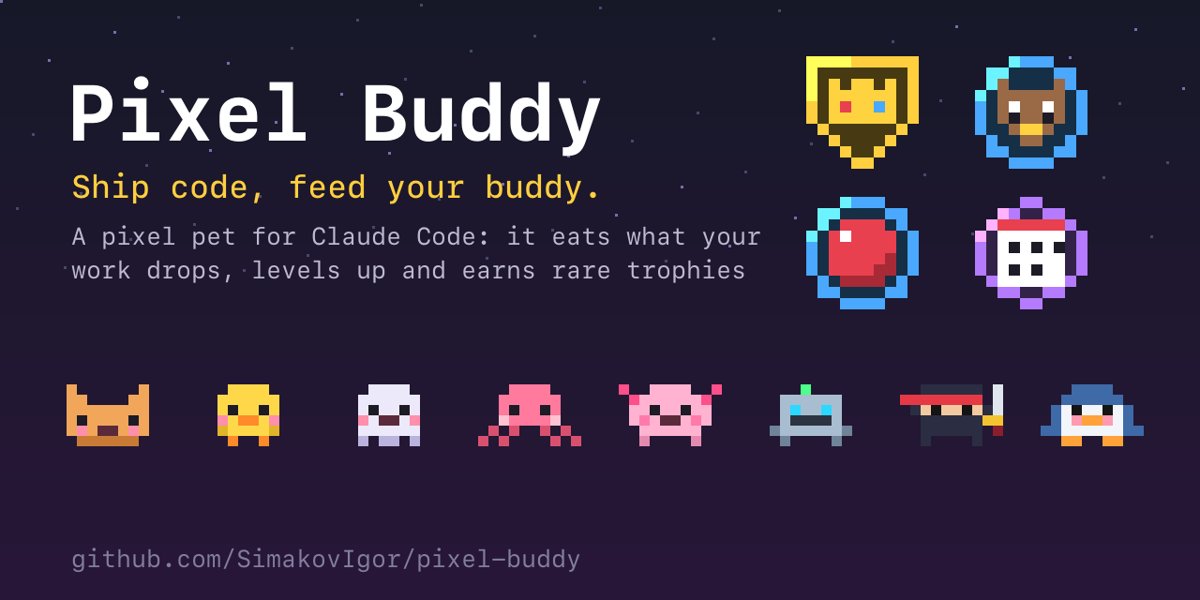
玩到约 1 万步时,Sonnet 3.7 写了 413 个记忆文件,分布在 225 个文件夹,拿到 1 枚徽章;Fable 5 写了 9 个文件(2 个文件夹)外加一个顶层 global.md,拿到 4 枚徽章。global.md 被用作看板,记录当前目标、预先写好的打道馆计划和模型自己的记忆使用规则。
Stainless 是 Anthropic 5 月收购的软件公司。评测使用其内部文档语料,约 35 万个文件、约 4.2 亿 token,共 25 道题,并让 Opus 5 agent 在 128 个会话里通过 dreaming 建设 wiki。dreaming 从 2 次会话扩大到 128 次时,25 道题的评分标准达标率从 13% 升到 48%。
同时使用搜索和 wiki 时,Claude 的总分随 wiki 增长从 54% 升到 61%;仅用搜索为 53%,仅用 wiki 最高为 48%。搜索加 wiki 每题还节省约 2 万 token。
文章称,告诉 Claude 记忆是做什么用的、而不规定怎么用,效果更好。当规则设为「只记录失败」时,Opus 5 和 Opus 4.7 都损失了记忆带来的大部分性能提升。
在 Harvey LAB 基准的一项收购合同任务中,起初的 wiki 指令下,生成的简报只涵盖 57 条事实中的 41 条(72%)。让 Claude 反思失败并重写指令、每份合同单独一页并逐字引用条款后,简报达标率升到 100%。